
Daftar Isi
- Teknik fine-tuning jaringan saraf untuk performa maksimal: Panduan Lengkap
- Strategi teknik fine-tuning jaringan saraf untuk performa maksimal
- Perbandingan Metode Fine‑Tuning Populer
- Langkah‑Langkah Praktis Memulai Fine‑Tuning
- Tips menghindari over‑fitting saat fine‑tuning
- Integrasi Fine‑Tuned Model ke Aplikasi Produksi
- Fine‑tuning pada data berbahasa Indonesia
- Kesalahan Umum yang Harus Dihindari
- Strategi lanjutan: Meta‑Learning & Few‑Shot Fine‑Tuning
Jika Anda pernah bermain-main dengan model deep learning, pasti sudah merasakan betapa menantangnya proses menyesuaikan (fine‑tune) jaringan saraf agar menghasilkan akurasi yang tinggi. Dari sekadar mengubah satu parameter hingga mengatur seluruh arsitektur, setiap langkah kecil bisa berpengaruh besar pada hasil akhir. Nah, artikel ini akan mengupas teknik fine-tuning jaringan saraf untuk performa maksimal secara lengkap, mulai dari persiapan data hingga trik lanjutan yang sering dipakai praktisi AI profesional.
Di era di mana model besar seperti GPT‑4 atau BERT menjadi standar, kemampuan memodifikasi model tersebut agar cocok dengan kebutuhan spesifik bisnis atau riset menjadi nilai jual utama. Karena itu, memahami fine‑tuning bukan hanya soal menurunkan loss, melainkan juga soal menghemat sumber daya komputasi, mempercepat waktu produksi, dan menjaga kestabilan model di lingkungan produksi.
Teknik fine-tuning jaringan saraf untuk performa maksimal: Panduan Lengkap
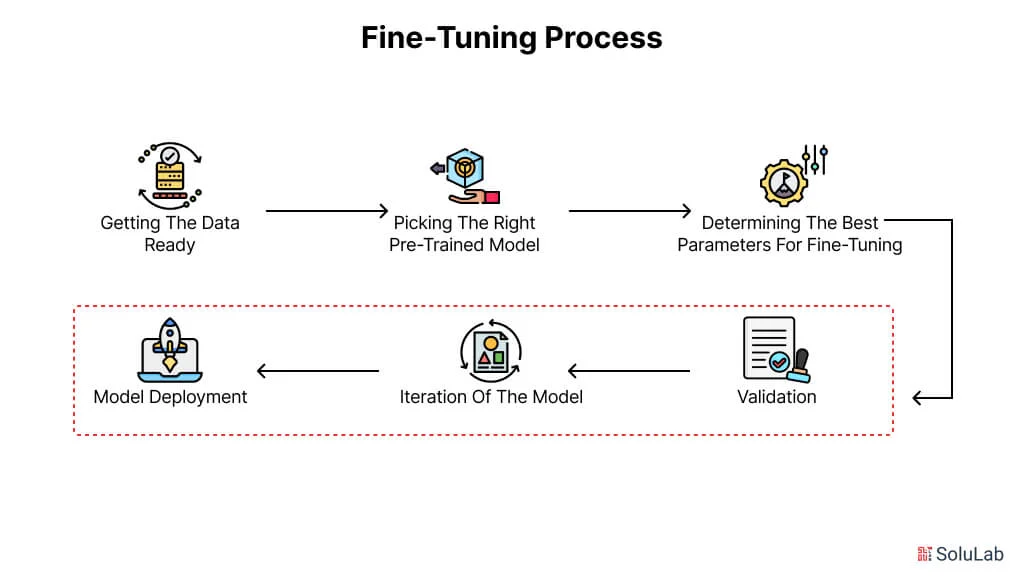
Berikut beberapa tahapan penting yang perlu Anda ikuti sebelum menyentuh kode:
- Analisis tujuan bisnis atau riset – Tentukan metrik yang paling relevan (accuracy, F1‑score, latency, dll).
- Persiapan data – Pastikan dataset bersih, terlabel dengan baik, dan representatif terhadap domain target.
- Pemilihan model dasar – Pilih model yang sudah ter‑pre‑trained pada tugas serupa (misalnya ResNet untuk gambar, RoBERTa untuk teks).
- Strategi fine‑tuning – Tentukan apakah akan melatih seluruh lapisan, hanya lapisan atas, atau menggunakan teknik hybrid.
- Optimasi hyperparameter – Learning rate, batch size, scheduler, dan regularisasi harus disesuaikan secara cermat.
Strategi teknik fine-tuning jaringan saraf untuk performa maksimal
Berbagai strategi sudah terbukti meningkatkan hasil fine‑tuning. Berikut rangkumannya:
- Layer Freezing – Bekukan lapisan awal (biasanya yang menangkap fitur umum) dan latih hanya lapisan akhir yang spesifik.
- Gradual Unfreezing – Lepas pembekuan secara bertahap, dimulai dari lapisan paling atas hingga paling bawah, sambil menurunkan learning rate.
- Learning Rate Scheduler – Gunakan scheduler seperti cosine annealing atau OneCyclePolicy untuk menghindari over‑fitting.
- Regularisasi – Dropout, weight decay, atau label smoothing dapat menstabilkan proses training.
- Data Augmentation – Untuk data gambar, teknik seperti mixup atau cutout dapat meningkatkan generalisasi.
Perbandingan Metode Fine‑Tuning Populer
| Metode | Keuntungan | Kekurangan | Kesesuaian Domain |
|---|---|---|---|
| Full Model Fine‑Tuning | Memungkinkan model belajar representasi baru secara menyeluruh. | Memakan memori & waktu komputasi tinggi. | Proyek dengan data besar & sumber daya kuat. |
| Layer Freezing | Lebih cepat, hemat GPU. | Risiko tidak dapat menyesuaikan fitur khusus. | Dataset kecil atau domain mirip dengan pre‑training. |
| Gradual Unfreezing | Menyeimbangkan kecepatan dan adaptasi. | Memerlukan tuning schedule tambahan. | Kasus menengah‑skala, perubahan domain signifikan. |
| Adapter Modules | Menambahkan lapisan ringan tanpa mengubah bobot utama. | Implementasi lebih kompleks. | Model bahasa besar, kebutuhan multitask. |
Langkah‑Langkah Praktis Memulai Fine‑Tuning
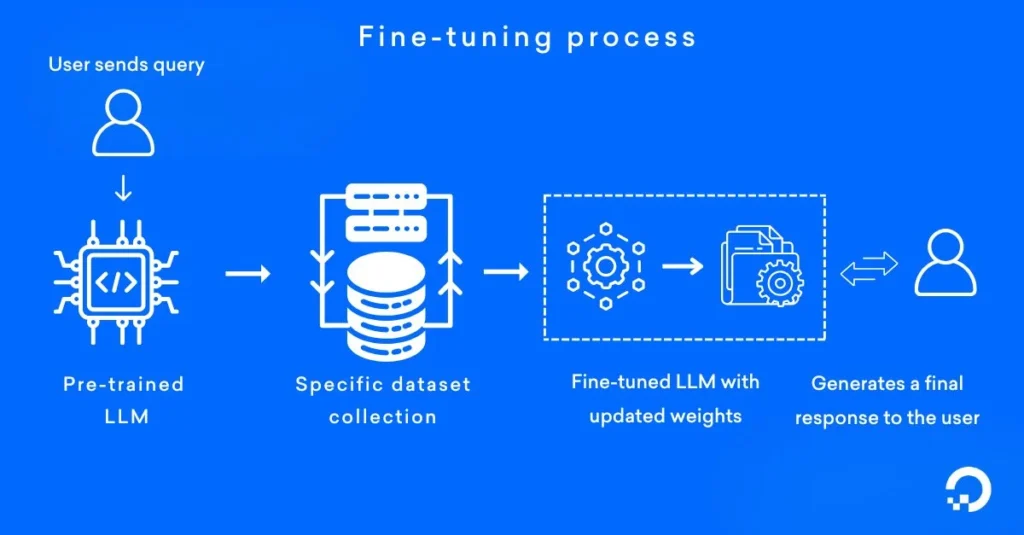
Setelah Anda memilih strategi, berikut alur kerja yang dapat di‑copy‑paste ke notebook Anda:
- Import library – Pastikan Anda menggunakan versi terbaru
torch,transformers, atautensorflow.kerassesuai kebutuhan. - Load model & tokenizer – Contoh untuk BERT:
from transformers import AutoModelForSequenceClassification, AutoTokenizer model = AutoModelForSequenceClassification.from_pretrained("bert-base-uncased") tokenizer = AutoTokenizer.from_pretrained("bert-base-uncased") - Siapkan dataset – Gunakan
datasetslibrary atautf.datauntuk streaming data. - Tetapkan optimizer & scheduler – Misalnya:
from torch.optim import AdamW from transformers import get_linear_schedule_with_warmup optimizer = AdamW(model.parameters(), lr=2e-5, weight_decay=0.01) scheduler = get_linear_schedule_with_warmup(optimizer, num_warmup_steps=0, num_training_steps=total_steps) - Training loop – Pastikan Anda mencatat loss dan metric setiap epoch.
- Evaluasi & early stopping – Gunakan
sklearn.metricsuntuk menghitung F1‑score atau AUC. - Export model – Simpan dalam format
.ptatau.onnxuntuk deployment.
Jika Anda baru memulai, optimasi hyperparameter AI dengan Bayesian optimization bisa menjadi tambahan yang sangat membantu untuk menemukan kombinasi learning rate dan batch size yang optimal tanpa harus mencoba semua kemungkinan secara manual.
Tips menghindari over‑fitting saat fine‑tuning
- Gunakan early stopping berdasarkan validation loss.
- Tambahkan weight decay yang cukup kecil (mis. 0.01).
- Jika dataset kecil, pertimbangkan k-fold cross‑validation untuk mengukur stabilitas model.
- Selalu periksa learning curve – jika training loss turun drastis tapi validation loss tetap tinggi, turunkan learning rate.
Integrasi Fine‑Tuned Model ke Aplikasi Produksi
Setelah model mencapai performa yang diinginkan, tantangan selanjutnya adalah mengintegrasikannya ke dalam pipeline produksi. Berikut beberapa poin penting yang sering terlewat:
- Model serving – Pilih antara
TorchServe,TensorFlow Serving, atau layanan cloud seperti AWS SageMaker. - Latency vs. Accuracy trade‑off – Jika aplikasi membutuhkan respons cepat, pertimbangkan model quantization atau pruning. Lihat Implementasi pruning model AI untuk efisiensi untuk teknik yang mudah di‑apply.
- Monitoring – Pasang alert untuk drift data dan penurunan akurasi.
- Versioning – Simpan setiap iterasi model dengan tag versi yang jelas, sehingga rollback menjadi mudah.
Jika Anda sedang mengerjakan proyek WordPress yang membutuhkan AI untuk rekomendasi konten atau analisis gambar, Anda bisa menggabungkan teknik fine‑tuning ini dengan cara mengoptimalkan SEO di WordPress untuk meningkatkan visibilitas hasil rekomendasi.
Fine‑tuning pada data berbahasa Indonesia
Bahasa Indonesia memiliki tantangan tersendiri seperti variasi dialek dan kata serapan. Berikut cara menyesuaikan model bahasa:
- Gunakan corpora lokal (mis. Indo4B atau dataset OSCAR ID).
- Lakukan tokenizer adaptation agar tokenisasi tidak memotong kata majemuk.
- Terapkan data augmentation berupa back‑translation (ID‑EN‑ID) untuk menambah variasi.
Setelah model siap, Anda dapat meng‑deploy-nya lewat API Flask atau FastAPI, lalu menghubungkannya ke plugin WordPress lewat endpoint REST. Kombinasi ini memungkinkan situs Anda menampilkan konten yang dipersonalisasi secara real‑time, meningkatkan engagement dan konversi.
Kesalahan Umum yang Harus Dihindari
Berikut beberapa jebakan yang sering ditemui oleh praktisi ketika melakukan teknik fine-tuning jaringan saraf untuk performa maksimal:
- Learning rate terlalu tinggi – Model dapat divergen dalam hitungan batch pertama.
- Data leakage – Pastikan tidak ada overlap antara training dan validation set.
- Penggunaan batch size yang tidak konsisten – Ini memengaruhi estimasi gradient dan dapat menurunkan stabilitas training.
- Kurangnya reproducibility – Simpan seed, versi library, dan konfigurasi hardware untuk audit.
Jika Anda mengalami kebingungan memilih optimizer yang tepat, biasanya AdamW dengan weight_decay menjadi pilihan aman untuk kebanyakan kasus NLP dan CV.
Strategi lanjutan: Meta‑Learning & Few‑Shot Fine‑Tuning
Untuk aplikasi yang memerlukan adaptasi cepat pada data sangat sedikit (few‑shot), teknik meta‑learning seperti Model‑Agnostic Meta‑Learning (MAML) atau Reptile dapat menjadi solusi. Ide dasarnya adalah melatih model agar “belajar belajar” sehingga ketika diberikan beberapa contoh baru, ia dapat beradaptasi dengan hanya beberapa langkah gradient descent.
Implementasi sederhana MAML dengan PyTorch dapat ditemukan di repositori learn2learn. Setelah Anda menguasai MAML, proses fine‑tuning menjadi hampir instan, cocok untuk produk SaaS yang melayani banyak klien dengan domain yang berbeda‑beda.
Untuk memperkaya pengetahuan Anda tentang teknik lanjutan, artikel Strategi Retargeting Iklan dengan Facebook Pixel memberikan contoh integrasi AI dalam kampanye iklan yang dapat dipadukan dengan model fine‑tuned Anda.
Dengan mengikuti panduan di atas, Anda tidak hanya meningkatkan akurasi model, tetapi juga mengoptimalkan penggunaan sumber daya, mempercepat time‑to‑market, dan menjaga kualitas layanan di lingkungan produksi. Selamat bereksperimen, dan jangan lupa untuk selalu mencatat hasil serta melakukan iterasi berkelanjutan – karena dalam dunia AI, tidak ada yang bersifat final, selalu ada ruang untuk perbaikan.