
Daftar Isi
- Implementasi pruning model AI untuk efisiensi: Apa itu dan Mengapa Penting
- Implementasi pruning model AI untuk efisiensi: Panduan Praktis Langkah demi Langkah
- Mengapa Pruning Meningkatkan Efisiensi
- Berbagai Teknik Pruning yang Populer
- Tips Praktis untuk Sukses dalam Implementasi Pruning Model AI untuk Efisiensi
- Studi Kasus: Pruning pada Model Vision Transformer (ViT)
- Integrasi Pruning dengan Teknik Optimasi Lain
Di era di mana model kecerdasan buatan (AI) semakin besar dan kompleks, tantangan utama bukan hanya menghasilkan akurasi yang tinggi, melainkan juga menjaga agar model tetap ringan, cepat, dan hemat sumber daya. Salah satu strategi yang kini semakin populer adalah pruning—memotong neuron atau koneksi yang tidak terlalu berkontribusi pada output akhir. Bagi banyak praktisi, implementasi pruning model AI untuk efisiensi menjadi jalan pintas yang menjanjikan untuk mengurangi beban komputasi tanpa mengorbankan performa.
Apalagi, dengan berkembangnya optimasi AI untuk analisis data besar, kebutuhan akan model yang cepat dan hemat memori menjadi lebih mendesak. Bayangkan Anda memiliki jaringan saraf yang berisi ratusan juta parameter; menjalankannya di perangkat edge atau smartphone jelas tidak praktis. Di sinilah pruning masuk sebagai solusi yang elegan: memangkas bagian-bagian yang “kurang berguna” sehingga model menjadi lebih ramping.
Artikel ini akan membahas seluk-beluk implementasi pruning model AI untuk efisiensi secara menyeluruh. Mulai dari konsep dasar, teknik-teknik yang paling efektif, hingga contoh langkah demi langkah yang dapat Anda terapkan pada proyek AI Anda. Kami juga akan menyelipkan beberapa strategi mengurangi overfitting pada model AI yang sering dipadukan dengan pruning untuk hasil yang maksimal.
Implementasi pruning model AI untuk efisiensi: Apa itu dan Mengapa Penting
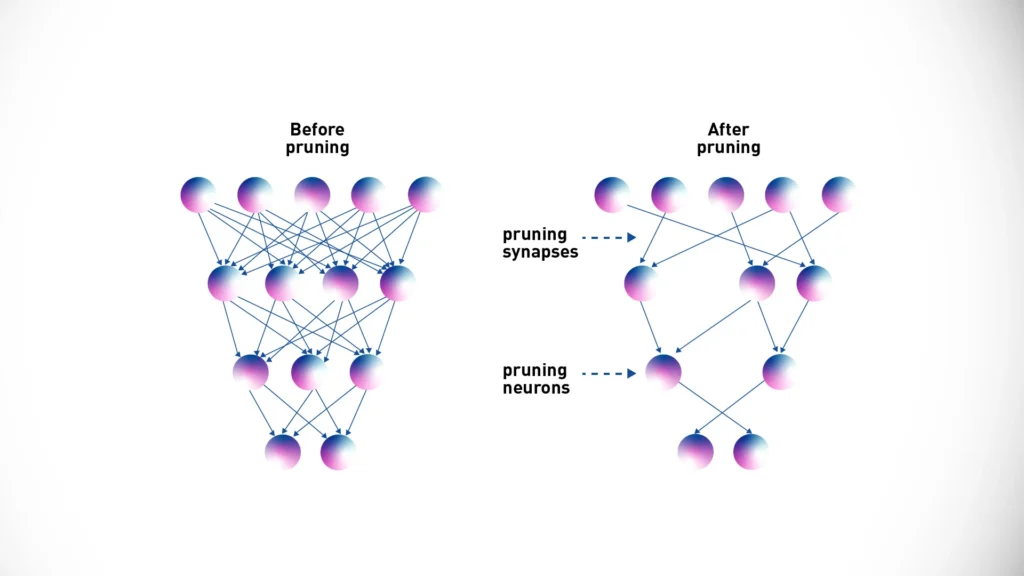
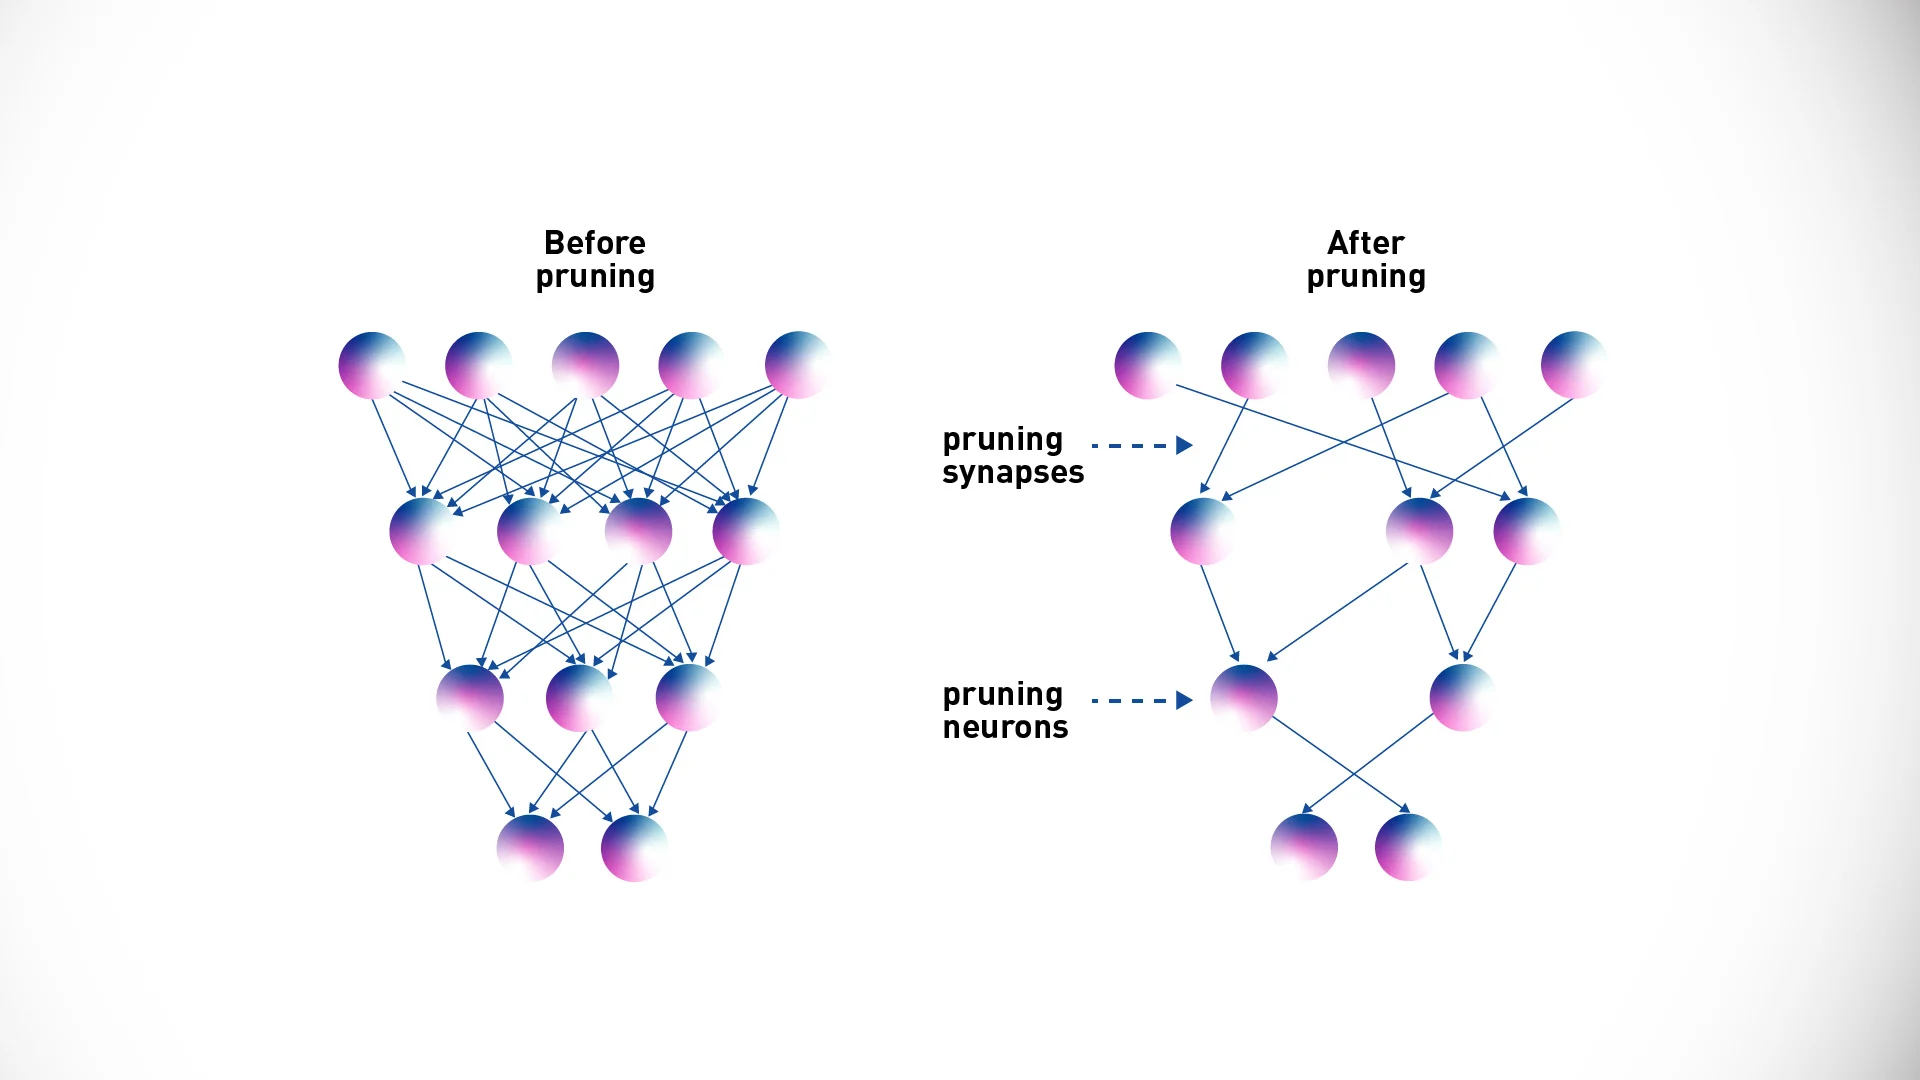
Pruning pada dasarnya adalah proses mengidentifikasi dan menghapus bobot (weight) atau neuron yang memiliki kontribusi minimal terhadap keputusan jaringan. Dengan cara ini, model menjadi lebih ringan, memori yang dibutuhkan berkurang, dan latency (waktu respons) menurun. Meskipun terdengar sederhana, teknik ini memerlukan pendekatan yang terukur agar tidak merusak akurasi model.
Berikut beberapa alasan kenapa implementasi pruning model AI untuk efisiensi menjadi langkah strategis:
- Penghematan sumber daya: Model yang dipruning biasanya membutuhkan kurangnya GPU/CPU time, yang berimbas pada biaya operasional yang lebih rendah.
- Kecepatan inferensi: Dengan lebih sedikit operasi matematis, model dapat memberikan respons lebih cepat, penting untuk aplikasi real‑time seperti kendaraan otonom atau aplikasi AR.
- Ukuran model yang lebih kecil: Memudahkan deployment ke perangkat edge, smartphone, atau microcontroller dengan memori terbatas.
- Potensi peningkatan generalisasi: Mengurangi kompleksitas model dapat membantu menghindari overfitting, terutama bila dipadukan dengan teknik regularisasi.
Implementasi pruning model AI untuk efisiensi: Panduan Praktis Langkah demi Langkah
Berikut alur umum yang dapat Anda ikuti untuk melakukan pruning pada model AI Anda:
- Pelatihan awal (baseline): Latih model secara konvensional hingga mencapai akurasi target.
- Evaluasi sensitivitas bobot: Gunakan metrik seperti magnitude (nilai absolut) atau kontribusi gradien untuk menilai pentingnya tiap bobot.
- Pemilihan threshold: Tentukan batas nilai di bawah mana bobot akan dipotong. Threshold biasanya dipilih secara empiris atau berdasarkan persentase sparsity yang diinginkan.
- Pruning: Hapus atau set bobot yang berada di bawah threshold menjadi nol.
- Fine‑tuning (re‑training): Setelah pruning, lakukan pelatihan kembali (few epochs) untuk memulihkan akurasi yang mungkin menurun.
- Validasi dan deployment: Uji model pada data validasi dan siapkan untuk deployment.
Jika Anda masih ragu, jangan lupa membaca strategi pemasaran digital untuk toko online yang menekankan pentingnya pengujian berulang—prinsip yang sama berlaku untuk proses pruning.
Mengapa Pruning Meningkatkan Efisiensi
Secara teknis, pruning mengurangi jumlah operasi matriks yang harus dijalankan selama fase inferensi. Setiap bobot yang dihapus berarti satu operasi perkalian‑penjumlahan tidak lagi diperlukan. Pada jaringan yang sangat dalam, pengurangan bahkan 10‑20% bobot dapat menghasilkan percepatan inferensi hingga 30‑40% tergantung pada hardware yang digunakan.
Selain itu, model yang lebih kecil memudahkan kompresi lebih lanjut, seperti quantization atau penggunaan format ONNX yang teroptimasi. Kombinasi teknik ini menjadi strategi komprehensif untuk implementasi pruning model AI untuk efisiensi yang maksimal.
Berbagai Teknik Pruning yang Populer
Berbagai pendekatan pruning memiliki kelebihan dan kekurangan masing‑masing. Berikut tabel perbandingan singkat yang merangkum tiga teknik utama yang sering dipilih oleh praktisi:
| Teknik | Ciri Khas | Keunggulan | Keterbatasan |
|---|---|---|---|
| Weight Pruning (Unstructured) | Memotong bobot individual berdasarkan magnitude. | Fleksibel, dapat mencapai sparsity tinggi. | Kurang efisien pada hardware standar karena pola sparsity tidak teratur. |
| Structured Pruning | Memotong seluruh filter, kanal, atau neuron. | Lebih mudah dioptimalkan pada GPU/CPU, mempercepat inference secara signifikan. | Biasanya menghasilkan sparsity yang lebih rendah dibanding unstructured. |
| Dynamic Pruning | Pruning dilakukan secara adaptif selama inference. | Menyesuaikan beban kerja real‑time, mengurangi energi pada perangkat edge. | Kompleksitas implementasi lebih tinggi, memerlukan kontrol runtime. |
Setelah memahami perbedaan teknik, Anda dapat memilih yang paling cocok dengan kebutuhan aplikasi dan infrastruktur Anda.
Tips Praktis untuk Sukses dalam Implementasi Pruning Model AI untuk Efisiensi
- Pilih metric sensitivitas yang tepat: Magnitude sederhana sudah cukup untuk banyak kasus, namun untuk model yang sangat sensitif, gunakan teknik berbasis Taylor expansion atau Hessian.
- Mulai dengan sparsity rendah: Misalnya 10‑15% pada iterasi pertama, lalu tingkatkan secara bertahap.
- Jangan lupakan fine‑tuning: Tanpa proses ini, akurasi dapat menurun drastis.
- Gunakan framework yang mendukung pruning: PyTorch (torch.nn.utils.prune), TensorFlow Model Optimization Toolkit, atau Keras TFMOT.
- Uji pada hardware target: Hasil simulasi di PC tidak selalu mencerminkan performa di perangkat mobile.
Studi Kasus: Pruning pada Model Vision Transformer (ViT)
Salah satu contoh nyata implementasi pruning model AI untuk efisiensi adalah pada Vision Transformer (ViT) yang awalnya memiliki ratusan juta parameter. Dengan menerapkan weight pruning sebesar 30% dan structured pruning pada beberapa head attention, tim riset berhasil menurunkan ukuran model dari 340 MB menjadi 210 MB sekaligus mempertahankan akurasi top‑1 hanya turun 0.5%.
Langkah‑langkah yang mereka lakukan meliputi:
- Melatih ViT baseline pada ImageNet selama 300 epoch.
- Menggunakan magnitude‑based pruning dengan threshold 0.02 pada semua weight matrix.
- Melakukan structured pruning pada 2 dari 12 attention heads yang paling sedikit berkontribusi.
- Fine‑tuning selama 20 epoch dengan learning rate yang lebih kecil.
- Deploy pada perangkat edge dengan TensorRT yang mengoptimalkan sparsity.
Hasilnya tidak hanya mengurangi latency inferensi sebesar 35%, tetapi juga menurunkan konsumsi daya listrik sebesar 22%—nilai penting bagi aplikasi IoT.
Integrasi Pruning dengan Teknik Optimasi Lain
Untuk memaksimalkan implementasi pruning model AI untuk efisiensi, banyak tim menggabungkan pruning dengan:
- Quantization: Mengubah bobot menjadi representasi 8‑bit atau bahkan 4‑bit.
- Knowledge Distillation: Menggunakan model besar (teacher) untuk melatih model kecil (student) setelah pruning.
- Neural Architecture Search (NAS): Menemukan arsitektur yang secara intrinsik lebih ringan.
Kolaborasi teknik-teknik ini menciptakan ekosistem model AI yang tidak hanya efisien, tetapi juga siap bersaing di pasar yang menuntut kecepatan dan biaya rendah.
Dengan memahami dasar-dasar, teknik, dan contoh penerapan, Anda kini memiliki pijakan kuat untuk memulai implementasi pruning model AI untuk efisiensi di proyek Anda. Ingatlah untuk selalu menguji secara menyeluruh, menyesuaikan threshold, dan memanfaatkan framework yang sudah terintegrasi dengan fitur pruning. Selamat bereksperimen, dan semoga model AI Anda menjadi lebih cepat, lebih ringan, dan tetap akurat!