
Daftar Isi
- Strategi Utama Mempercepat Inferensi AI pada Perangkat Edge
- 1. Optimasi Model: Quantization, Pruning, dan Knowledge Distillation
- 2. Pilih Hardware yang Tepat: NPU, GPU, atau CPU?
- 3. Teknik Deployment Cerdas: Model Partitioning & On‑Device Runtime
- Implementasi Praktis: Langkah‑langkah Mempercepat Inferensi AI pada Perangkat Edge
- Langkah 1: Pilih Model Dasar yang Sesuai
- Langkah 2: Lakukan Quantization Aware Training (QAT)
- Langkah 3: Prune dan Fine‑Tune Kembali
- Langkah 4: Konversi ke Format Edge-Friendly
- Langkah 5: Benchmark dan Iterate
- Tips Tambahan untuk Mempercepat Inferensi AI pada Perangkat Edge
- Studi Kasus: Penggunaan Edge TPU pada Sistem Kamera Keamanan
- Kesimpulan Akhir
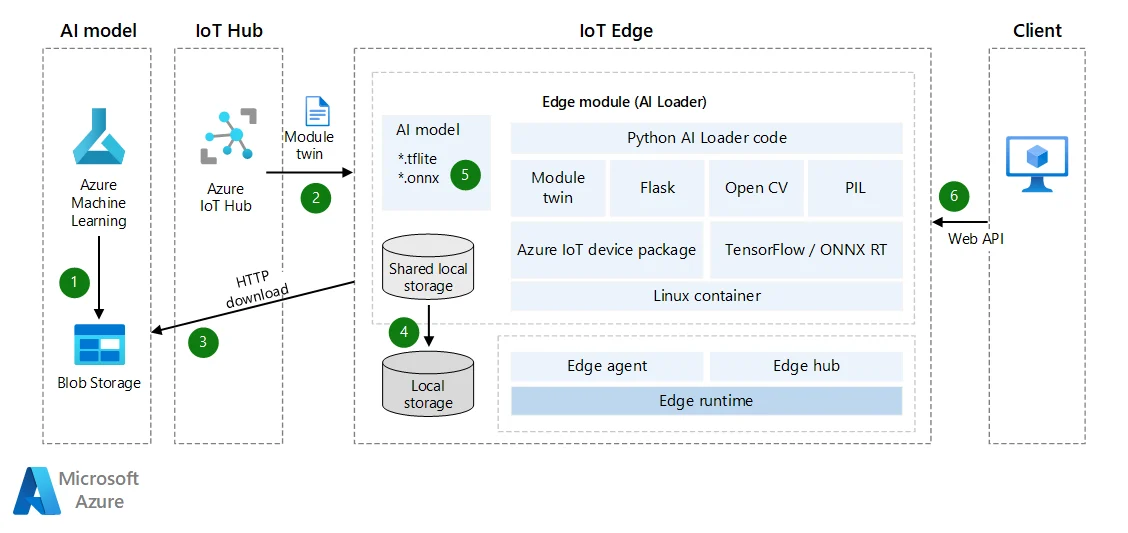
Era digital kini tak lagi hanya berpusat pada server raksasa di pusat data. Semakin banyak aplikasi menuntut kecerdasan buatan (AI) berjalan langsung di perangkat edge—dari kamera keamanan pintar hingga sensor IoT di pabrik. Namun, menjalankan model deep learning yang kompleks pada hardware terbatas bukan perkara mudah. Di sinilah tantangan mempercepat inferensi AI pada perangkat edge menjadi sangat krusial.
Artikel ini bakal mengupas tuntas strategi-strategi yang dapat mempercepat inferensi AI pada perangkat edge, mulai dari optimasi model, pemilihan hardware, hingga teknik deployment yang cerdas. Kita akan menelusuri contoh konkret, membandingkan pilihan yang ada, serta menyelipkan beberapa link internal yang relevan untuk memperkaya pemahaman Anda.
Strategi Utama Mempercepat Inferensi AI pada Perangkat Edge
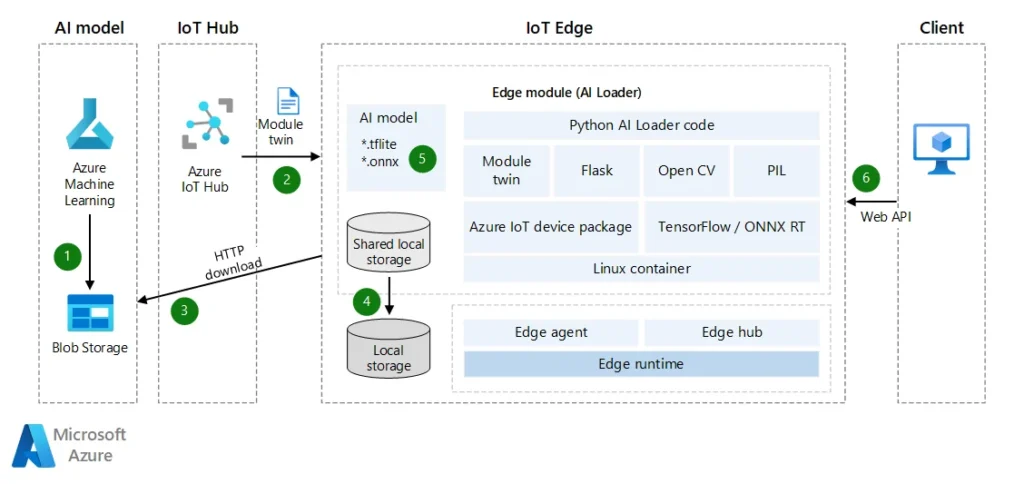
Secara umum, percepatan inferensi AI pada perangkat edge dapat dibagi menjadi tiga pilar utama: optimasi model, optimalisasi hardware, dan teknik deployment cerdas. Kombinasi yang tepat antara ketiganya akan menghasilkan performa yang jauh melampaui harapan.
1. Optimasi Model: Quantization, Pruning, dan Knowledge Distillation
Optimasi model adalah langkah pertama yang paling sering dilakukan. Berikut beberapa teknik yang paling populer:
- Quantization: Mengubah bobot dan aktivasi dari 32‑bit floating point menjadi 8‑bit integer (atau bahkan 4‑bit). Ini mengurangi ukuran memori dan mempercepat operasi aritmetika pada DSP atau NPU.
- Pruning: Menghapus neuron atau filter yang kurang berkontribusi pada akurasi. Pruning dapat memotong hingga 70% parameter tanpa mengorbankan kualitas secara signifikan.
- Knowledge Distillation: Melatih model kecil (student) untuk meniru perilaku model besar (teacher). Hasilnya model ringan yang tetap mempertahankan akurasi tinggi.
Jika Anda penasaran bagaimana teknik-teknik ini bekerja dalam konteks computer vision, cek Optimasi AI untuk Aplikasi Computer Vision: Panduan Praktis 2026 untuk contoh implementasinya.
2. Pilih Hardware yang Tepat: NPU, GPU, atau CPU?
Berbagai jenis akselerator tersedia di pasar edge, masing‑masing dengan kelebihan dan keterbatasannya. Berikut tabel perbandingan singkat yang membantu Anda menentukan pilihan:
| Jenis Akselerator | Kelebihan | Kekurangan | Contoh Produk |
|---|---|---|---|
| CPU (ARM Cortex‑A76) | Fleksibel, mudah diprogram | Kecepatan terbatas pada beban berat | Raspberry Pi 4, Jetson Nano |
| GPU (NVIDIA Jetson AGX) | Paralelisme tinggi, dukungan CUDA | Konsumsi daya lebih tinggi | NVIDIA Jetson Xavier |
| NPU (Google Edge TPU) | Optimasi inferensi 8‑bit, daya rendah | Hanya mendukung model yang sudah di‑quantize | Coral Dev Board |
| DSP (Qualcomm Hexagon) | Efisiensi energi, baik untuk audio dan sensor | Kurang umum untuk vision | Snapdragon 8‑gen 2 |
Jika Anda ingin menekan biaya komputasi di cloud sambil tetap mengandalkan edge, baca Tips menghemat biaya komputasi AI di cloud – Panduan Praktis untuk strategi hybrid yang efektif.
3. Teknik Deployment Cerdas: Model Partitioning & On‑Device Runtime
Selain memperbaiki model dan hardware, cara Anda men-deploy juga berpengaruh besar. Beberapa teknik yang patut dicoba:
- Model Partitioning: Memecah jaringan menjadi sub‑model yang berjalan pada komponen berbeda (misalnya, preprocessing di CPU, inferensi utama di NPU).
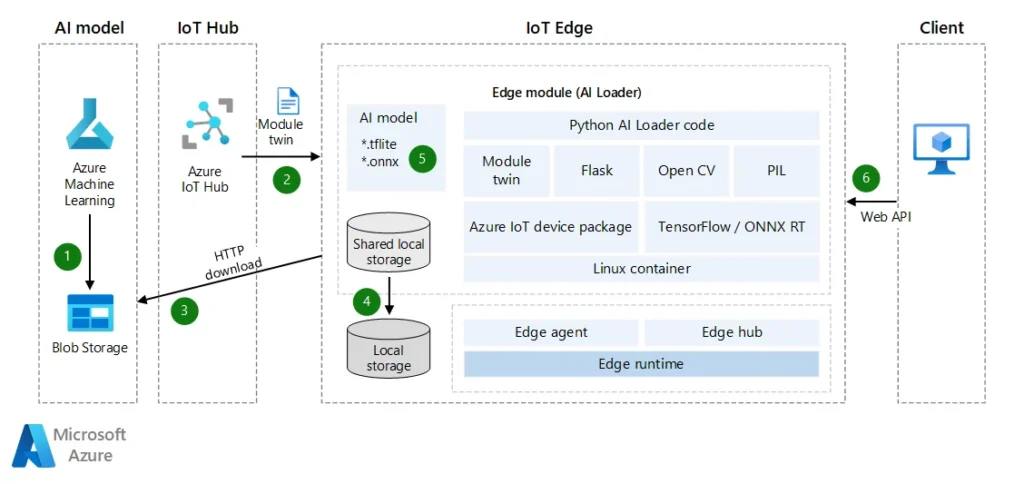
- Edge Runtime Optimizer: Menggunakan runtime seperti TensorRT, TVM, atau ONNX Runtime yang otomatis meng‑generate kernel optimal untuk target hardware.
- Lazy Loading: Hanya memuat bagian model yang diperlukan pada saat itu, mengurangi beban memori.
Implementasi Praktis: Langkah‑langkah Mempercepat Inferensi AI pada Perangkat Edge
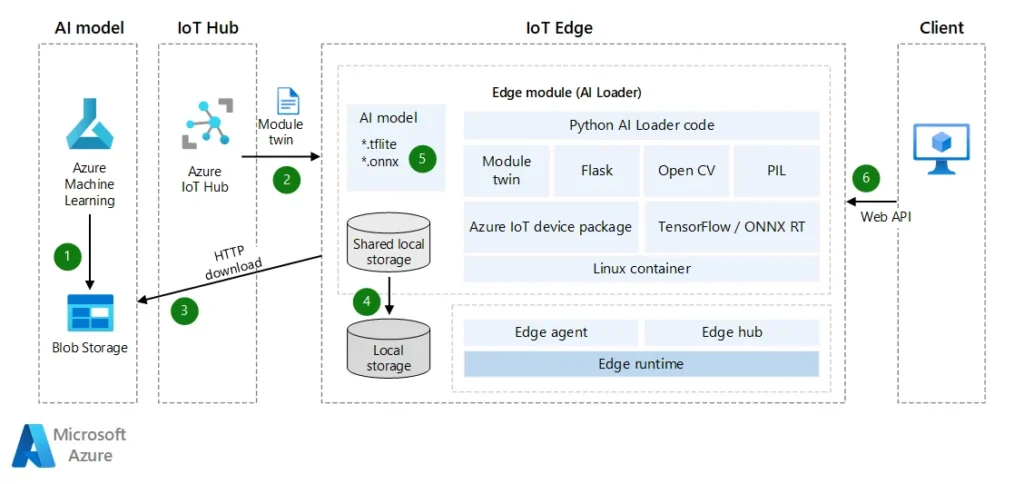
Berikut alur kerja yang dapat Anda ikuti secara berurutan, lengkap dengan tips khusus untuk tiap fase.
Langkah 1: Pilih Model Dasar yang Sesuai
Mulailah dengan model yang memang dirancang untuk edge, seperti MobileNetV3, EfficientNet‑Lite, atau TinyBERT. Model-model ini sudah di‑optimalkan secara struktural sehingga proses quantization atau pruning menjadi lebih mudah.
Langkah 2: Lakukan Quantization Aware Training (QAT)
QAT melibatkan simulasi efek quantization selama proses training, sehingga model “mengetahui” batasan 8‑bit sebelum di‑export. Hasilnya biasanya hanya 1–2% penurunan akurasi dibandingkan model floating‑point.
Langkah 3: Prune dan Fine‑Tune Kembali
Setelah QAT, terapkan pruning dengan threshold yang konservatif (misalnya, menghapus filter dengan magnitude < 0.01). Lakukan fine‑tuning beberapa epoch untuk mengembalikan performa yang hilang.
Untuk teknik fine‑tuning yang lebih mendalam, Anda bisa merujuk pada Teknik fine‑tuning jaringan saraf untuk performa maksimal – Panduan Praktis.
Langkah 4: Konversi ke Format Edge-Friendly
Gunakan TensorFlow Lite, ONNX, atau PyTorch Mobile untuk meng‑export model yang sudah di‑optimasi. Pastikan Anda men‑enable opsi “delegate” untuk NPU atau DSP yang tersedia pada device.
Langkah 5: Benchmark dan Iterate
Setelah model ter‑deploy, lakukan benchmark real‑world menggunakan tools seperti mlperf atau benchmark_model yang disediakan oleh vendor. Catat latency, throughput, dan konsumsi daya. Jika hasil belum memuaskan, kembali ke langkah 2 atau 3 untuk iterasi lebih lanjut.
Tips Tambahan untuk Mempercepat Inferensi AI pada Perangkat Edge
- Gunakan Batch Size = 1: Pada kebanyakan edge device, batch size 1 memberikan latency terendah karena tidak ada akumulasi data.
- Optimalkan Pre‑Processing: Alihkan operasi seperti resizing atau normalisasi ke GPU/NPU bila memungkinkan.
- Manfaatkan Sparsity: Beberapa NPU mendukung sparse matrix multiplication yang mempercepat inference pada model yang dipruning secara agresif.
- Cache Model di Flash: Simpan model dalam format ter‑compressed di storage yang cepat (eMMC, UFS) untuk mengurangi waktu load.
- Update Firmware Secara Berkala: Vendor hardware sering merilis driver yang meningkatkan performa runtime.
Studi Kasus: Penggunaan Edge TPU pada Sistem Kamera Keamanan
Sebuah startup keamanan menggunakan Google Coral Edge TPU untuk mendeteksi wajah dalam video streaming 1080p. Dengan model MobileNetV2 yang di‑quantize ke 8‑bit, mereka berhasil menurunkan latency dari 120 ms menjadi 35 ms per frame, sekaligus mengurangi konsumsi daya dari 3 W ke 0.8 W. Hasil ini memungkinkan kamera beroperasi secara mandiri tanpa perlu mengirim data ke cloud.
Pengalaman ini menegaskan pentingnya mempercepat inferensi AI pada perangkat edge bukan hanya soal kecepatan, tetapi juga soal efisiensi energi dan privasi data.
Kesimpulan Akhir
Mempercepat inferensi AI pada perangkat edge memang menantang, namun dengan pendekatan terstruktur—optimasi model lewat quantization, pruning, dan knowledge distillation, pemilihan hardware yang tepat, serta deployment yang cerdas—Anda dapat mencapai performa yang hampir setara dengan server pusat. Selalu lakukan benchmarking, iterasi, dan perbarui firmware untuk menjaga agar sistem tetap berada di puncak efisiensi.
Semoga panduan ini membantu Anda menavigasi dunia AI edge yang dinamis. Selamat bereksperimen, dan jangan ragu untuk mengeksplorasi teknik‑teknik baru yang terus muncul di dunia AI!