
Daftar Isi
- Strategi Utama dalam Optimasi Performa AI di Perangkat Mobile
- 1. Pemilihan Arsitektur Model Ringan
- 2. Kompresi Model melalui Quantization
- 3. Pruning (Pemangkasan) dan Sparsity
- 4. Knowledge Distillation
- 5. Memanfaatkan Hardware Acceleration
- 6. Optimasi Runtime dan Memory Management
- 7. Profiling dan Pengujian di Berbagai Perangkat
- Perbandingan Teknik Optimasi Utama
- Implementasi Praktis dengan TensorFlow Lite
- Pertimbangan Tambahan untuk Pengembangan Aplikasi AI Mobile
- Manajemen Baterai dan Thermal Throttling
- Keamanan Model dan Data
- Penggunaan Data Sintetis untuk Training
- Automasi CI/CD untuk Model
- Studi Kasus: Aplikasi Pengenalan Wajah pada Smartphone
- Langkah Selanjutnya untuk Pengembang
Perkembangan kecerdasan buatan (AI) tidak lagi terbatas pada server berdaya tinggi. Pengguna kini menuntut aplikasi yang dapat menjalankan model AI secara langsung di ponsel, tablet, atau perangkat wearable. Tantangan utama yang dihadapi developer adalah bagaimana mempertahankan akurasi model sekaligus menurunkan beban komputasi, memori, serta konsumsi daya. Dalam konteks ini, optimasi performa AI di perangkat mobile menjadi topik krusial yang harus dikuasai.
Berbagai faktor berperan, mulai dari arsitektur hardware (CPU, GPU, DSP, NPU) hingga cara model dilatih dan di‑export. Tidak cukup hanya meng‑upload model “besar” ke Play Store; tanpa proses optimasi, aplikasi akan mengalami lag, crash, atau menguras baterai secara berlebihan. Oleh karena itu, artikel ini akan membahas strategi menyeluruh untuk mengoptimalkan performa AI di perangkat mobile, sekaligus memberikan contoh praktis yang dapat langsung diimplementasikan.
Selain itu, kami juga akan menyinggung bagaimana data sintetis dapat meningkatkan akurasi model tanpa menambah beban komputasi, sebuah strategi meningkatkan akurasi AI dengan data sintetis yang relevan bagi pengembang yang ingin menyeimbangkan kualitas dan efisiensi.
Strategi Utama dalam Optimasi Performa AI di Perangkat Mobile
Berikut ini adalah rangkaian langkah yang dapat dijadikan peta jalan bagi tim pengembangan. Setiap langkah dirancang agar kompatibel dengan ekosistem Android maupun iOS, serta mendukung kerangka kerja populer seperti TensorFlow Lite, PyTorch Mobile, dan Core ML.
1. Pemilihan Arsitektur Model Ringan
Model yang dirancang khusus untuk edge device, seperti MobileNet, EfficientNet‑Lite, atau SqueezeNet, sudah mengintegrasikan prinsip efisiensi sejak fase desain. Memilih arsitektur yang tepat dapat mengurangi kebutuhan memori hingga 70 % dibandingkan model konvensional.
2. Kompresi Model melalui Quantization
Quantization mengubah bobot dan aktivasi dari representasi floating‑point 32‑bit menjadi 8‑bit integer atau bahkan 4‑bit. Teknik ini tidak hanya memperkecil ukuran file (biasanya 4×), tetapi juga mempercepat inferensi pada hardware yang mendukung integer arithmetic. Di TensorFlow Lite, proses ini dapat dilakukan dengan satu perintah tflite_convert --post_training_quantize.
3. Pruning (Pemangkasan) dan Sparsity
Pruning mengeliminasi neuron atau koneksi yang memiliki nilai bobot mendekati nol. Setelah pruning, model dapat di‑re‑train untuk memulihkan akurasi. Hasilnya adalah jaringan yang lebih ramping, dengan beban komputasi yang berkurang secara signifikan pada perangkat mobile.
4. Knowledge Distillation
Dalam teknik ini, model “guru” besar melatih model “murid” yang lebih kecil. Murid belajar meniru output probabilistik guru, sehingga dapat mempertahankan performa yang hampir setara meski ukurannya jauh lebih kecil. Knowledge distillation cocok dipadukan dengan quantization untuk hasil optimal.
5. Memanfaatkan Hardware Acceleration
Setiap platform mobile menawarkan akselerator khusus: GPU pada Android, Metal pada iOS, serta NPU atau DSP pada chipset terbaru (misalnya Qualcomm Hexagon, MediaTek APU). Menggunakan API seperti Android Neural Networks API (NNAPI) atau Core ML dapat memindahkan beban komputasi ke akselerator, menghasilkan inferensi yang lebih cepat dan hemat energi.
6. Optimasi Runtime dan Memory Management
Penggunaan batch size yang tepat, pemanggilan model secara asinkron, serta manajemen memori (misalnya dengan TensorBuffer yang di‑re‑use) dapat menghindari fragmentasi memori dan penurunan kinerja pada aplikasi yang berjalan lama.
7. Profiling dan Pengujian di Berbagai Perangkat
Setiap perangkat memiliki karakteristik yang berbeda. Alat profiling seperti Android Studio Profiler, Xcode Instruments, atau TensorFlow Lite Benchmark Tool membantu mengidentifikasi bottleneck, baik pada CPU, GPU, maupun memori.
Perbandingan Teknik Optimasi Utama
| Teknik | Ukuran Model (Pengurangan) | Penurunan Akurasi | Kecepatan Inferensi | Kesesuaian Hardware |
|---|---|---|---|---|
| Quantization 8‑bit | ~75 % | 0‑2 % | +1.5‑2× | CPU, GPU, NPU (dengan integer support) |
| Pruning (50 % sparsity) | ~40 % | 1‑3 % | +1.2‑1.5× (tergantung dukungan sparsity) | CPU, GPU (dengan sparse matrix ops) |
| Knowledge Distillation | ~60‑80 % | ≤1 % | +1.3‑1.8× | Semua akselerator |
| Model Lightweight (MobileNetV3) | ~70‑85 % | 0‑2 % | +2‑3× | CPU, GPU, NPU |
Tabel di atas memberikan gambaran singkat mengenai trade‑off masing‑masing teknik. Pilihan terbaik biasanya merupakan kombinasi beberapa teknik, misalnya menggunakan MobileNetV3 yang telah di‑quantize dan diprune.
Implementasi Praktis dengan TensorFlow Lite
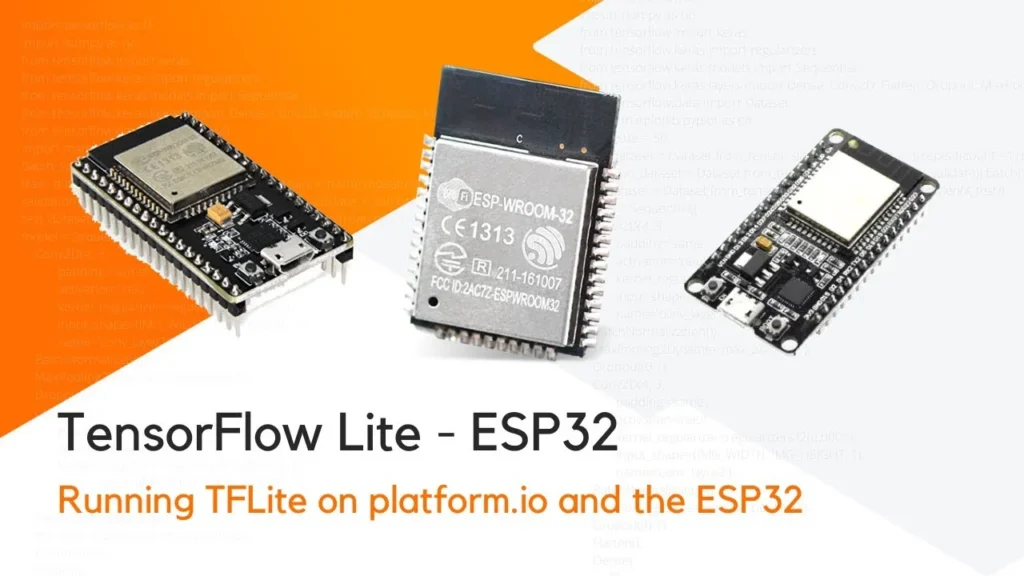
TensorFlow Lite (TFLite) adalah framework yang paling banyak dipakai untuk menjalankan model AI di perangkat mobile. Berikut alur kerja yang dapat diikuti:
- Persiapan Model: Mulailah dengan model TensorFlow yang telah ter‑train. Pastikan dataset mencakup variasi kondisi real‑world.
- Konversi ke TFLite: Gunakan
tf.lite.TFLiteConverteruntuk meng‑export model menjadi file.tflite. Sertakan opsioptimizations=[tf.lite.Optimize.DEFAULT]untuk mengaktifkan quantization otomatis. - Fine‑tuning (Opsional): Jika akurasi turun signifikan setelah quantization, lakukan post‑training quantization aware training (QAT) dengan
tf.quantization.fake_quant_with_min_max_vars. - Integrasi ke Aplikasi: Tambahkan dependensi
org.tensorflow:tensorflow-litepada Android atauTensorFlowLiteSwiftpada iOS. GunakanInterpreteruntuk memuat model dan menjalankan inference. - Penggunaan NNAPI / Core ML: Pada Android, aktifkan
interpreter.setUseNNAPI(true)untuk memanfaatkan akselerator. Pada iOS, konversi ke.mlmodelmelaluicoremltoolsdan manfaatkan Metal.
Setelah implementasi, lakukan profiling menggunakan Android Memory Profiler atau Xcode Instruments. Perhatikan metrik latency, throughput, dan konsumsi energi.
Pertimbangan Tambahan untuk Pengembangan Aplikasi AI Mobile
Manajemen Baterai dan Thermal Throttling
Inferensi berkelanjutan dapat menyebabkan peningkatan suhu dan konsumsi daya. Strategi pengelolaan meliputi:
- Menjalankan inferensi hanya ketika aplikasi berada di foreground.
- Menggunakan batch inference pada interval tertentu, bukan setiap frame.
- Mengaktifkan mode “low‑power” pada akselerator, jika tersedia.
Keamanan Model dan Data
Model yang di‑deploy pada perangkat dapat di‑reverse engineering. Enkripsi model (misalnya dengan Android’s EncryptedFile) serta penggunaan on‑device inference tanpa mengirim data ke server meningkatkan privasi pengguna.
Penggunaan Data Sintetis untuk Training
Seringkali, data real‑world sulit dikumpulkan dalam jumlah besar. Dengan memanfaatkan data sintetis, pengembang dapat meningkatkan keragaman data latih tanpa menambah beban komputasi pada perangkat. Baca lebih lanjut pada strategi meningkatkan akurasi AI dengan data sintetis untuk memahami proses generasi dan validasinya.
Automasi CI/CD untuk Model
Integrasikan pipeline CI/CD yang otomatis meng‑konversi, meng‑quantize, dan meng‑uji model setiap kali ada perubahan kode. Dengan begitu, tim dapat memastikan setiap rilis aplikasi selalu membawa model yang paling optimal.
Studi Kasus: Aplikasi Pengenalan Wajah pada Smartphone
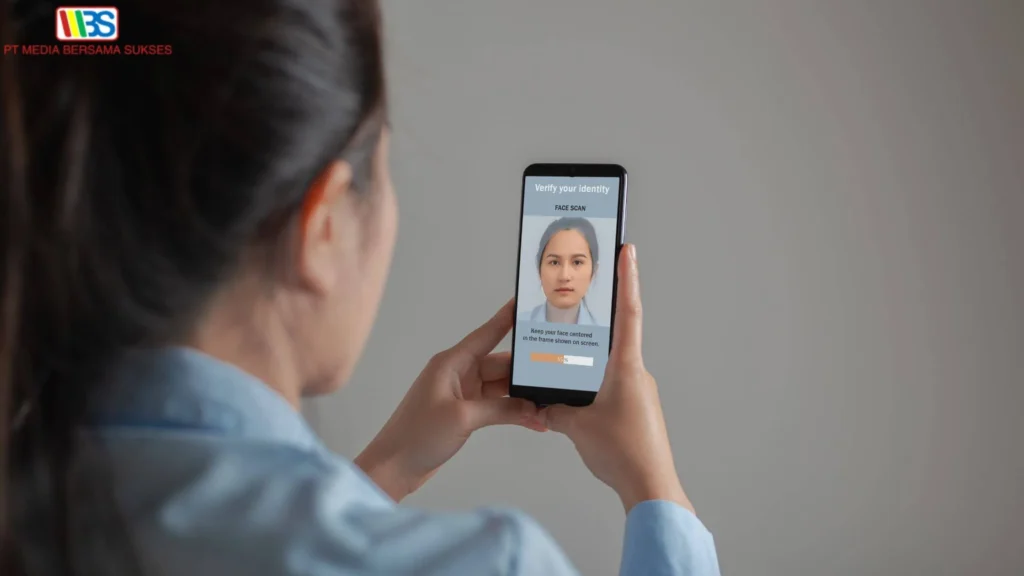
Sebuah startup mengembangkan aplikasi pengenalan wajah untuk membuka kunci ponsel. Model awalnya adalah ResNet‑50 dengan akurasi 98 % namun ukuran 98 MB. Setelah menerapkan rangkaian optimasi performa AI di perangkat mobile berikut, hasilnya:
- Model diganti menjadi MobileNetV3‑Small (12 MB).
- Quantization 8‑bit mengurangi ukuran menjadi 3 MB.
- Pruning 40 % menurunkan FLOPs sebesar 35 %.
- Inferensi di‑offload ke NPU pada chipset Snapdragon 888, latency turun dari 250 ms ke 45 ms.
- Konsumsi baterai berkurang 30 % pada penggunaan harian.
Akibatnya, aplikasi berhasil melewati proses review Google Play Store dengan rating kinerja tinggi, dan pengguna melaporkan pengalaman yang lebih responsif.
Langkah Selanjutnya untuk Pengembang
Setelah memahami teknik-teknik utama, berikut checklist yang dapat diikuti sebelum merilis aplikasi:
- Pastikan model telah di‑quantize dan diprune.
- Uji model pada minimal tiga tipe perangkat (low‑end, mid‑range, high‑end).
- Gunakan profiling untuk memverifikasi bahwa latency < 50 ms pada perangkat target.
- Implementasikan fallback ke CPU jika akselerator tidak tersedia.
- Enkripsi file model dan aktifkan kebijakan privasi data.
- Siapkan pipeline otomatis untuk memperbarui model secara berkala.
Dengan mengikuti langkah‑langkah tersebut, developer tidak hanya meningkatkan performa AI di perangkat mobile, tetapi juga memberikan pengalaman pengguna yang mulus, aman, dan hemat energi.
Terakhir, ingatlah bahwa dunia AI mobile terus berkembang. Chipset baru dengan akselerator AI yang lebih kuat, framework yang lebih canggih, serta metode kompresi yang semakin inovatif akan terus muncul. Selalu ikuti perkembangan terbaru, lakukan eksperimen, dan adaptasikan strategi optimasi agar aplikasi tetap relevan dan kompetitif.